为啥中国一半算力都在造爽剧?
- 2026-11-21 12:16:26
最近有张图在外网被看了八十多万次,国内科技圈也吵翻了。
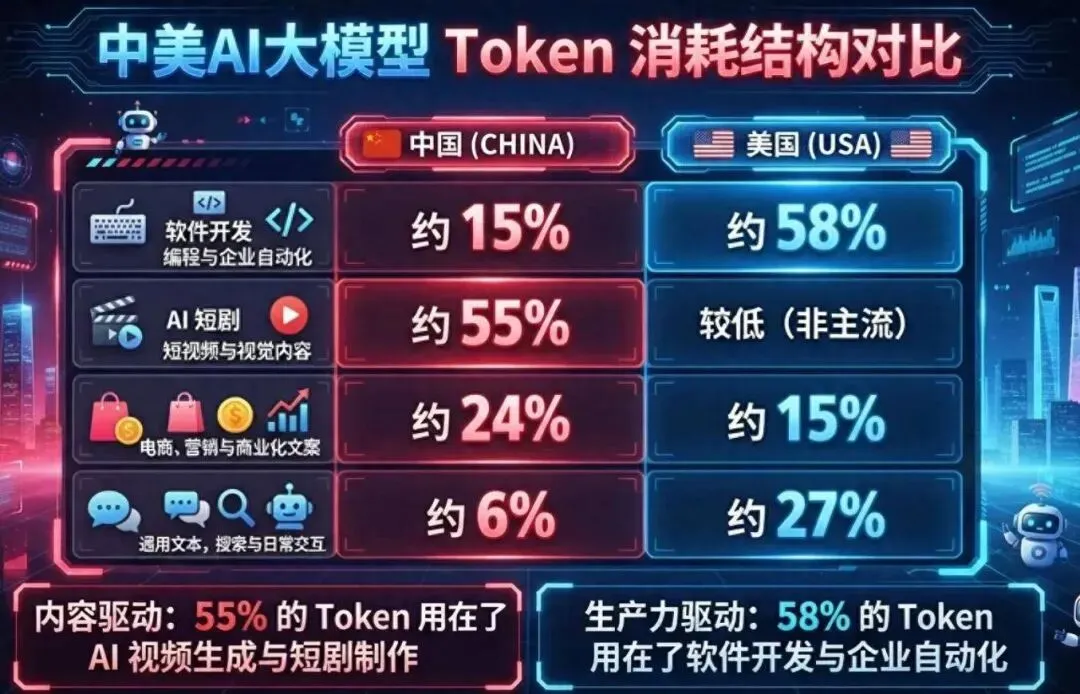
图上就两行字。中国消耗的 token,第一名是短剧和短视频,占 55%;美国消耗的 token,第一名是编程和企业自动化,占 58%。
有人看完甩出一句话:AI 时代,中国人再一次把火药做成了烟花。
这句话情绪很足,也很扎心。但它其实做了一件事——把一张统计图,读成了一个道德判断。
统计图能告诉你钱花在哪,告诉不了你哪条路更高尚。真正值得琢磨的,是另一层问题:为什么两个国家,会把手里的稀缺资源,喂给了完全不同的东西?
一、先把数据摆上桌
中国的这一半,来源是中文在线在 2026 年 6 月投资者交流中援引的行业数据:AI 短剧与视频生成,55%,第一;电商与营销,24%;软件开发,15%;其余教育、政企知识库、金融、通用聊天等,约 6%。一句话概括——中国的 token,主要流向了"内容生产"。
美国的这一半,公开口径有好几套,但方向高度一致。在 OpenRouter 等平台样本里,代码开发与企业 Agent 约 48%,企业办公、RAG 知识库、政企自动化约 22%,电商营销与短视频素材约 13%,通用聊天约 9%,AI 短剧与文生视频只有约 4%。流传最广的版本,是"编程生成 + 企业自动化合计约 58%"。
表 1 中美 Token 消耗用途结构对比(2026 年公开样本口径)
用途 | 中国 | 美国 |
AI 短剧与视频生成 | 55% | 约 4% |
电商与营销素材 | 24% | 约 13% |
软件开发 / 编程 | 15% | 约 48%—58% |
企业办公、知识库与自动化 | 计入"其他" | 约 22% |
通用聊天 | 计入"其他" | 约 9% |
其他(教育、政企、金融等) | 约 6% | — |
注:两边口径不同,不可直接相加比较;中国数据为行业样本,美国数据为公有 API 样本。
换成企业视角,图景更清楚。Menlo Ventures 的企业调研显示,编程一项就占了企业生成式 AI 使用量的约 51%、部门级 AI 支出的约 55%,大约 40 亿美元——是所有用途里唯一一个"断层第一"。Anthropic 的经济指数报告提供了一个更细的切面:在其企业 API 流量里,计算机与数学类任务占约 44%,软件开发生成任务在所有被统计国家都稳定在 37% 到 40%;企业 API 的对话中,77% 是"直接委托 AI 把活干完",而消费端只有约一半。
如果按"有多少大企业在用"来排,顺序是:代码生成 70%、客户支持 58%、内部知识检索 55%、销售营销内容 52%、文档处理 48%、法务审查 30%、财务分析 28%、医疗临床 20%。
所以美国的 token,主要流向了"生产力"。
一句话记住:同一个 token,在美国是生产工具,在中国是内容原材料。这不代表谁更高级,只代表两边"离钱最近的地方"不一样。 |
二、美国为什么死磕代码?答案藏在一张工资单里
很多人以为这是技术选择,其实首先是一笔账。
硅谷一个资深的软件工程师,年薪普遍在 30 万到 50 万美元之间,总包更高也不稀奇。对企业来说,每多招一个人,就是每年几十万美元的持续硬成本。而 AI 编程 Agent 跑一次任务,烧掉几万到几十万 token,折成钱是几美元到几十美元。只要能省下高级工程师三个小时,这笔买卖就稳赚。
但光算账还不够,还有两个更底层的原因。
第一,代码可验证。这是它最被低估的一点。企业采购新技术最怕什么?怕说不清效果。营销文案提升了品牌吗?客服机器人真的降本了吗?都是糊账。但代码不一样——单元测试跑不跑得通、构建过不过,是黑是白。在一个"ROI 要向上汇报"的环境里,可验证性本身就是最大的竞争力。
第二,付费习惯。在美国,软件、SaaS、云服务早就写进了企业的预算表,跟租办公室、交水电费一样属于刚性支出。企业订阅一个 AI 编程工具,不需要从零开始解释"这东西值不值得买"。而在中国,很多企业买硬件、建机房、换大屏很爽快,对持续订阅软件和服务却算得很细。
这两条合起来,编程就滚起来了。而且现在的 AI 编程工具,已经不是补全几行代码的小插件——它能把上百万行的工程整体读进上下文,你给它一句"把支付模块从 Stripe 切到同时支持数字货币",它自己翻文档、改依赖、跑单测、修 bug,一次串完。
代价也不是没有。Uber 五千人的工程团队,Claude Code 的渗透率从年初的三成冲到八成以上,每个工程师每月在 token 上花五百到两千美元,公司整个 2026 年的 AI 编程预算不到四个月就烧完了。Meta 那边更夸张,员工三十天内通过编程工具消耗掉六十万亿 token。微软甚至因为第三方编程工具用量超标,把内部相关预算砍掉了三分之一以上。
烧钱,但烧得心甘情愿。因为省下的是人力。
三、中国为什么扑向短剧和带货?一句"不想"说不通
回到那个反问:AI 写代码这么有价值,国内算力为什么不往编码上堆?
答案不是不想,是难收到钱。
先看一个容易被忽略的结构性数字:中国的 IT 支出里,硬件占比高,软件和服务加起来只占两成上下。摩根士丹利的研报显示,中国软件及 IT 服务支出只占全球的约 4.9%。这意味着,toB 的 AI 工具在国内面对的是一个付费意愿稀薄、单价被压得很低的市场。做 AI 编程工具的团队出去谈合作,常见的画面是:客户承认工具好,但希望你先免费帮忙改造遗留系统,再配上长期驻场支持,最后还要一个极大幅度的折扣。
C 端则是另一片土壤。中国有全球最大的内容消费市场和电商市场,短视频、直播、电商这条链路被磨得极其成熟——一条内容能带来多少点击、多少停留、多少转化,有细到分钟级的监测。只要一条短剧能带来充值、广告或下单,token 就立刻有了清晰的回报路径。
还有一层容易被忽略的"物理法则":视频的算力密度,天生就碾压文本。
按主流视频模型的计费口径,一个 5 秒的 720p 镜头,大约消耗 15 万到 30 万 token;而一部十万字的短剧剧本,输出 token 也就十来万。一个镜头,约等于一整部剧本。一部 90 分钟的 AI 短剧,光成片 token 就在亿级;再加上创作者普遍要"抽卡"——同一个镜头生成三四次才挑出一条能用的——单部剧实际消耗轻松突破数亿。
视频生成和文本生成,差了三到四个数量级。
所以那个 55%,很大程度上是计量规则推上去的,不能简单理解成"中国一半的 AI 资源都投在了娱乐上"。
而它背后确实也有真金白银。2025 年全球微短剧市场规模接近 180 亿美元,中国占 77.78%,突破 140 亿美元;2026 年前 8 个月,国内上线微短剧约 43 万部,是去年全年的 13 倍;仅抖音一家平台,今年上半年就新上了 22 万部 AI 短剧。郑州昔日以横店闻名,如今被称为"竖店",八百多家微短剧企业、四万从业者,日均开机上百部。
这不是虚火,是一条真实的产业链,养活着几万家企业、几十万人。
四、三个必须澄清的误读
在讨论这件事之前,有三个误读得先拆掉。
误读一:55% 意味着中国一半算力在拍短剧。不是。Token 占比不等于算力占比。视频的 token 单价和密度比文本高几个数量级,所以同样一笔算力,转化成 token 数量后会被放大很多倍。真正需要看的是算力卡时、数据中心负载这些口径,而这类数据两边都不完整公开。
误读二:这两组数都是全行业普查。也不是。中国的 55% 来自中文在线援引的行业 Token 调用数据,口径和统计范围并没有完整交代;美国的 58% 是"公有 API"口径,不包含各家第一方 App 里的自有流量。两者都是样本,不是普查。用样本画趋势可以,用样本下判决不行。
误读三:Token 占比就等于价值占比。更不成立。视频模型耗 token 多,但单条内容覆盖的用户量也大。反过来,美国编程 token 烧得多,产出的是软件产品和自动化系统,价值体现在企业效率和产品迭代上。两边花 token 的方式不同,赚回来的东西也不同——一个有规模,一个有单价。
读这类数据的三个提醒:一是 Token 占比 ≠ 算力占比 ≠ 价值占比;二是几套口径不能互相加总;三是"通用对话"占比看起来高,很大程度是消费级娱乐流量拉起来的,剔除之后,严肃用途基本就是"编程 + Agent"。 |
五、真正的分野不在雅俗,在"谁付钱"
把情绪剥掉,这件事的本质其实很朴素:算力流向哪里,是由成本、用户、产业链和现金流共同决定的,不是由审美决定的。
美国的企业软件市场,早就变成了水电煤一样的基础设施,AI 编程工具一嵌进工作流就直接产生可量化的回报,所以 token 自然往那儿汇。
中国的消费互联网,把内容到交易这条链路打磨到了极致,AI 视频技术一落地,最先跑出规模的就是离用户最近的地方,所以 token 自然往那儿汇。
一个市场先把 AI 用在企业每天要写的、要跑的系统上;另一个市场先把 AI 用在老百姓每天要看的、要买的东西上。这不是谁更高级,是各自的条件长出来的两条路。
顺带说一个少有人提的结构性差异。美国的算力物理形态正在高度集中:按 JLL 的数据,2026 年上半年北美数据中心租户需求里,微软、亚马逊、谷歌、Meta、甲骨文这些超大规模云厂商占了约 59%,在建管线的 81.6% 是 hyperscale 类型,而"企业自建数据中心"作为一个新建类别,已经基本归零。这种集中度是它效率红利惊人的原因,也是它红利分配不均的原因。
六、美国那半壁,也不是坦途
把美国那条路想得太顺,同样是一种误读。
先看成本。a16z 引用的 OpenRouter 遥测数据显示,自主 agent 消耗的 token 总量已经是人类直接对话的近 5 倍,而且从今年 2 月到现在的半年里暴增了 14 倍;更关键的是,这些消耗里超过 85% 来自缓存前缀——因为 agent 是目标驱动的渐进读写循环,每一步都要把几万甚至十万 token 的上下文重新喂回去。
再看分化。企业端的消耗极不均衡:普通企业的 token 消耗只是翻倍,前 10% 的头部企业却暴增了 17 倍,科技信息产业内部的差距拉到了 32.5 倍。所谓"美国全在用 AI 干活",其实高度集中在少数头部公司身上。
还有一层更安静的代价:组织能力。同一批调研显示,管理领导力技能的提及下降了 7%,学习发展类下降了 13%,企业内部晋升率几近停滞。当 AI 把初级岗位的活接走,新人从哪里长出来、管理者从哪里冒出来,这些问题美国自己也没答案。
最后,别以为美国就没有"娱乐流量"。a16z 的报告里有一句很关键的话:仅创意角色扮演一类,就占开源模型 token 用量的一半以上。它只是不上新闻标题、不签采购合同、不进企业年报,所以在企业视角里"看不见"。所以"美国=纯生产、中国=纯娱乐"是一个偷懒的对比。更准确的说法是:中国的行业份额叙事由内容工厂主导,美国的企业支出叙事由编程主导。区别在于——谁在新闻里,谁在合同里。
七、两条路各自真正的风险
美国这条路的第一个风险是分配。效率红利高度集中在头部企业和超大规模厂商手里,中小企业拿不到同等好处(数据也印证了:250 人以上企业有 30% 在用 AI,20 人以下只有 17%)。第二个风险是电力。业内的共识是"AI 的尽头是电力供应",而今年美国已经进入电力缺口时代,数据中心排队等电,成了扩张的实质瓶颈。
中国这条路的第一个风险,是把"应用套现"当成终点。内容侧的钱好赚、链路短、见钱快,但它是低垂的果实。如果算力长期只往内容侧走,底层模型和高端算力的差距会被一寸寸拉开。可以对照两个数字:在 EpochAI 的 FP8 精度口径下,美国约占全球 AI 算力规模的 75%,中国约 14% 至 15%;DeepSeek 创始人梁文锋也说过一句实话——不是模型能力已经足够,而是受算力硬性限制,落后美国十二到十八个月。
第二个风险是内容的自我消耗。爽剧的套路就那么几套:赘婿逆袭、霸道总裁、一夜暴富、穿越开挂。用最稀缺的资源批量生产最同质化的多巴胺,短期是产业,长期是审美透支。好消息是监管已经在收紧——今年前 8 个月,全网下架了约 6.8 万部违规微短剧,行业正在被推向精品化和规范化。
八、那么,该怎么看这件事
我的态度是两句话:不必自卑,也别自满。
不必自卑,是因为中国走出了一条符合自身条件、且被验证有效的路径——从最贴近消费者的内容、电商场景切入,先把技术用起来、把商业模式跑通、把市场养起来,再逐步向工业、研发渗透。这不是"走偏了",这是一条务实路线。而且短剧产业在逼着国产模型进化:稳定角色、连续镜头、画面一致性、低延迟推理、批量生成素材,这些全是硬技术。
也别自满,是因为真正的考题从来不是"娱乐还是科研",而是另外三件更硬的事。
九、结尾总结
回到开头那张图,它说的是事实:美国把 token 喂给了代码,中国把 token 喂给了内容。
但它没说出口的那半句是:美国喂给代码,是因为那里有人付钱;中国喂给内容,也是因为那里有人付钱。
算力的流向,从来不是市场自发的结果,而是一个国家的价值排序。你把稀缺资源喂给什么,本质上就是在选择要成为什么。
真正值得警惕的,不是"中国人把火药做成了烟花"。是把当下的最优解,当成了永远的最优解。
历史总是惊人的相似,我们不仅要懂得火药做烟花可以放,更要明白火药终究还有别的用法。

