算力都去造爽剧了,可为什么你做一集还是那么贵
- 2026-11-19 08:49:25
「国内超一半算力在造爽剧」这句话,上周在行业里刷了屏。
它有一个能查到的源头。中文在线在 2026 年 6 月 3 日的一份投资者关系活动记录表里写:在国内所有 Token 消耗份额中,AI 短剧与视频生成占 55%,电商与营销占 24%,此前被寄予厚望的软件开发只占 15%。
10 月 16 日,一篇叫《一半算力在造爽剧,98.7% 都回不了本》的文章把这个数字翻译成了公众语言。舆论当天就炸了。
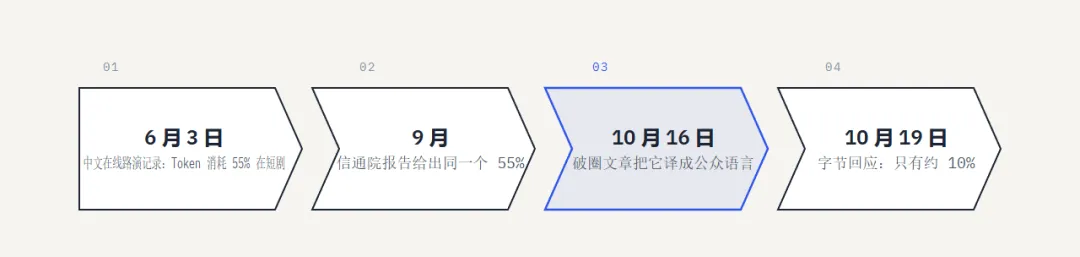
然后字节这边开了口。10 月 19 日,豆包公关负责人刘星在微博说,某公司发布的这个算力数据有些不靠谱,就字节来说,公司总算力中只有约 10% 用于视频生成模型的训练和推理。他把转发内容里那三个比例逐处标了「不实」。
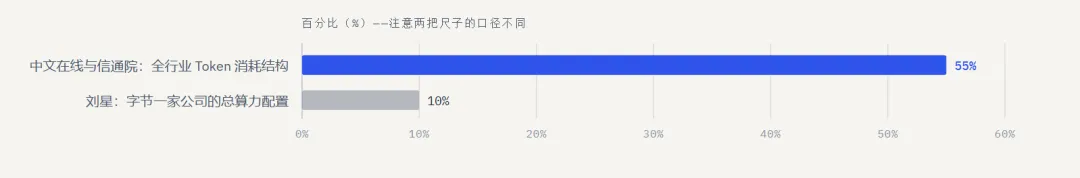
一个是 55%,一个是 10%,差了五倍多。
这两个数都成立,也都不能代表全国。它们量的根本不是同一件事。
55% 不是一家公司说的
这是这件事最容易看漏的一层。
翻一下时间线会发现,给 55% 的不止那家上市公司。2026 年 9 月,中国信通院发布《词元(Token)经济发展研究报告(2026 年)》,同样写着 AI 短剧与视频生成已成为词元消耗的核心应用引擎,占据全行业词元消耗份额的 55%,位列第一;AI 营销与电商紧随其后,占 24%。
一份上市公司的路演记录,一份国家级智库报告,两个月,同一个数。
这就是为什么这件事和一般谣言不一样。它不是说有人编了个数,而是一个数被第二个更硬的来源垫高了。批评它的人如果只盯着「某公司重仓押注 AI 短剧、利益相关」,就漏掉了信通院这一层。
同时也要说清楚,这两个来源的共同问题是没有方法。中文在线那份材料未交代统计机构、样本范围、统计周期和测算方法。财新网在报道里补了一句:目前市场上缺乏公信力较高的第三方数据测算国内大致的 Token 消耗场景分布。
换句话说,55% 是目前能查到的最硬口径,但它依然不是一个经过完整方法披露的数字。
为什么短剧能吃下这么大一份,中文在线给了解释:短剧对视频生成和 Token 周转速度要求极高,AI 仿真人剧对帧数和 1080p 的要求更严,Token 消耗量通常是偏漫画形态、720p 的 AI 漫剧的两到三倍。实际制片时团队还得反复抽卡生成、筛选画面,消耗自然持续。
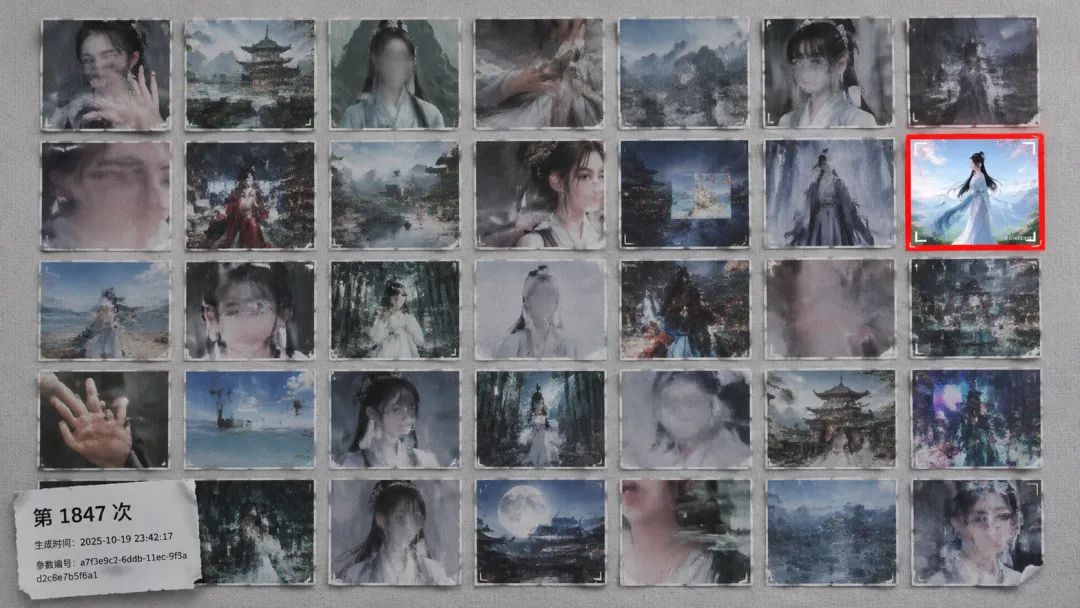
它甚至认为这种高消耗构成了行业壁垒:门槛低,但天花板高,中小团队很难负担顶尖作品的制作成本。
10% 也不是临时编的
刘星那个数同样有出处,只是出处在另一把尺子上。
他量的是字节一家公司的总算力配置:这么多算力里,多少拿去训练和推理视频生成模型。10% 是配置比例,是资源分配。
中文在线和信通院量的是全行业的 Token 消耗结构:已经跑起来的调用里,哪类业务花得多。55% 是结果结构,是流水去向。
一个是家里总共囤了多少米,一个是花出去的钱流向了哪里。 拿行业的均值套到单一公司头上,本来就粗糙。
还有一个细节值得记一下:刘星没有透露字节总算力的规模,也没有说明剩下约 90% 的算力分配去向。他只否定了那个数,没有给出自己的全景。
他在评论区的回复反而更技术。有网友说,视频生成的模型 token 其实没有语言模型多,因为语言模型的 input 会占很多 token,尤其是 Agent 多轮对话。刘星回了一句:确实如此。
这句话是下面所有分歧的根。
刘星没有给出字节的全景,但公开口径里有几个数可以垫一下。截至 2026 年 6 月,豆包大模型日均 Token 调用量突破 180 万亿,一年增长超过 10 倍。豆包 2025 年第四季度月活 2.27 亿,是国内首个日活破亿的 AI 原生应用。即梦 AI 的月活约在 1000 万到 1600 万之间,不同机构的口径差异较大,但它是国内 AI 视频生成工具里排第一的那个。
这些数字说明一件事:字节确实在跑视频生成,也跑得不小。问题只在比例上,而比例的算法取决于你把哪一部分算进分母。
一周的代码,不够 1 天的短剧
Token 和算力之间,隔着一个很容易被跳过的东西。
Token 是模型处理信息的计费单位,一个词可能拆成好几个 Token。算力讲的是 GPU 在单位时间内的实际运算量。不同任务跑同样的 Token,算力开销可以差很远。
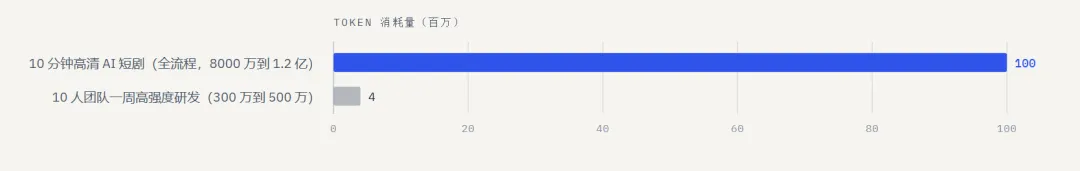
行业里有一组通用测算:一段 10 分钟的高清 AI 短剧,全流程生成需要消耗 8000 万到 1.2 亿 Token;一支 8 到 10 人的技术研发团队,一周高强度研发的总 Token 消耗大概只有 300 万到 500 万。
新京报贝壳财经的佘宗明拿这组数下过一个结论:就算花一周时间用 AI 写代码,消耗的 Token 都远不及用 1 天做 AI 短剧。
把单位价值再摊开看,差距更极端。消费级场景约 0.01 美元/百万词元,产业级场景,比如药物研发、金融量化、精密代码生成,可以到 1000 美元/百万词元,相差十万倍。
所以「谁烧得多」和「谁在干正事」之间,没有直接的换算关系。视频生成是高密度消耗场景,代码生成是低密度高效场景,两种 Token 连计价单位都不是同一套。
信通院的另一组数可以作为注脚:中国日均词元调用量从 2024 年初的 1000 亿涨到 2026 年 6 月的 500 万亿。单集 1.5 分钟的 AI 短剧,词元消耗量可达 500 万到 1000 万。
短剧烧的是推理的通用卡
还有一层更少人提,但它决定了这场争论值不值得吵。
DataEye 研究院负责人刘尊在中国新闻周刊里说,AI 短剧成为 Token 消耗大户,本质是应用规模化带来的流量结果,不等于它吃掉大量高端稀缺算力。
他的拆分是:AI 短剧很多环节用的是通用模型、中低端卡,与科研、基础大模型训练用的高端算力不是同一类资源。科研场景的算力主要烧在预训练和微调,那是重 GPU 的活;AI 短剧的 Token 消耗绝大部分集中在推理阶段。
推理算力市场和训练算力市场是相对分割的两条供给线,采购主体、硬件型号、成本体系都不一样。
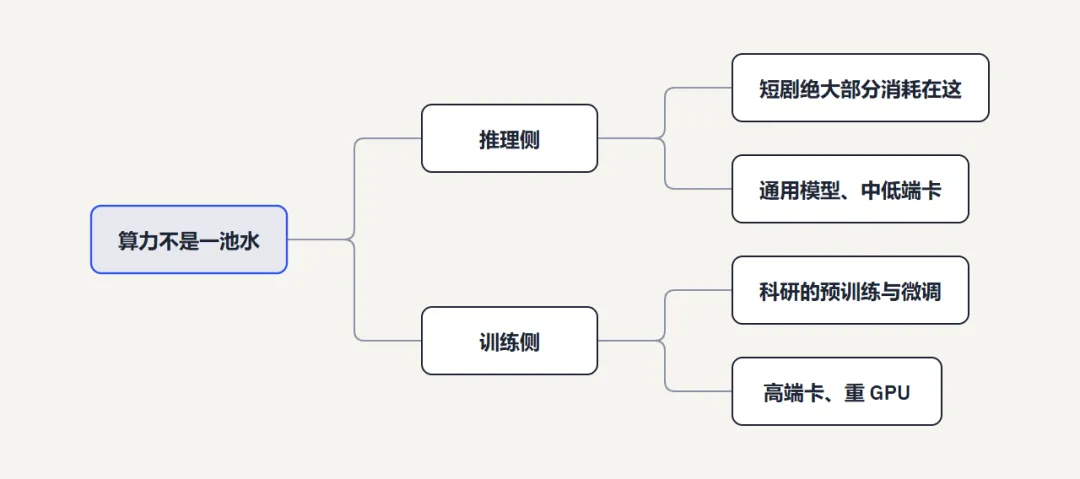
结论因此变得很朴素:不能简单理解成短剧用了 Token,科研就没得用。
同一篇报道里还有一条对美国那侧数字的反驳。佘宗明指出,流传的「美国约 58% 的 Token 流向代码生成和企业自动化」查无出处,a16z、麦肯锡、Gartner 都没说过这类数据。他补了一条更实际的观察:美国 API 平台上代码生成的 Token 占比确实很高,但里面有大量是中国程序员贡献的,很多大陆大厂的软件工程师用 Claude 写代码,这些消耗记在美国的账上。
一边是查无出处的 58%,一边是有两个来源但没披露方法的 55%。把它们摆在一起得出「美国 AI 提生产力、中国 AI 造奶头乐」,用的是两个都不牢的数。
你那一集的账,卡只占三成五
争论落到做内容的人身上,数字是另一副样子。
国家广电总局在 9 月 17 日的国新办发布会上给过一组数:全国微短剧用户已超 8 亿,2025 年市场规模突破千亿元;今年前 8 个月上线微短剧 43 万部,是去年全年的 13 倍,其中 AI 剧占比超九成。
QuestMobile 的数据显示,截至 2026 年 7 月,红果短剧独立 App 日活 1.68 亿,同比增长 107%,已经超过腾讯视频、爱奇艺、优酷、芒果 TV 四家日活之和,用户人均单日停留时长约 125 分钟。短剧用户规模截至 2026 年 5 月为 8.51 亿,覆盖近七成移动互联网用户。
产业的底盘是真的。野村证券今年 10 月的调研估算,Seedance 被用于行业内 80% 至 90% 的 AI 短剧生产流程。
把视线放到全球,中国在这个市场里的位置比争论里说的更重。2026 年 4 月,由国家广播电视总局发展研究中心等共同完成的《AI 驱动全球微短剧创新发展报告》显示,2025 年全球微短剧市场规模接近 180 亿美元,其中中国突破 140 亿美元,占全球的 77.78%。海外市场内购收入排名前十的头部短剧平台全部是中国背景,合计内购收入约 16.50 亿美元,占海外市场规模的 45.83%。
同一份报告估算,2026 年国内 AI 剧与漫剧的产能规模可能迅速突破 100 万部。前 8 个月那 43 万部里超过九成有 AI 参与,覆盖剧本生成、虚拟拍摄、后期剪辑、标签生成、配音译制和投流宣发,信通院测算部分环节的效率提升达到 50% 到 80%。
一个占全球四分之三以上份额、产能以 1 年 13 倍速度往上翻的市场,它消耗掉全行业一半的推理 Token,并不需要什么阴谋解释。
但真正该看的是成本结构。《微短剧创作指引》里的拆解是:算力占 AI 短剧成本结构的 35%,人力成本占 40%,其他成本占 25%。算力已经是 AI 内容生产的核心成本要素,但它排在人后面。
烧掉全行业一半 Token 的活,花钱的大头依然是人,不是卡。
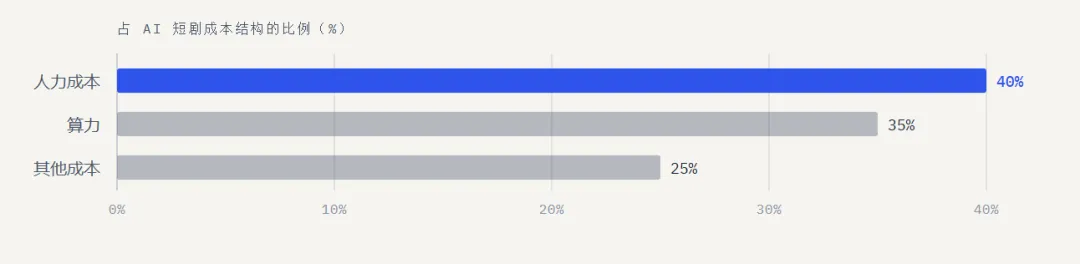
这一条对做这行的人最实在:全网都在骂算力被短剧吃掉的时候,你付账时最大的那一项还是自己的人。更别说信通院专家拆过,电力成本占算力运营成本的 60% 以上,硬件折旧约占 20% 到 25%,这门生意最大的成本项其实是电。
还有一个变量会让这类争论反复出现。信通院给的对比是,以 OpenClaw 为代表的智能体,单次任务词元消耗量可达普通对话程序的 10 至 100 倍。聊天是问一句答一句,智能体拿到一个目标后要自己拆步骤、调工具、反复试错,每一步都在烧词元。
这也解释了为什么不同场景的消耗结构会一直变。当智能体成为主流入口,今天排第一的场景明天可能就换人,而每一次换位都会带来一轮新的百分之多少。
信通院对这条产业曲线也给了一个阶段性判断:中国词元产业正从期望膨胀期快速向幻灭期切换,未来 1 至 2 年步入幻灭调整期,3 至 5 年逐步迈入生产成熟期。
按这个节奏,围绕百分之多少的吵架还会来好几轮。真正能用来做判断的,从来不是那个百分比本身,而是它背后是哪把尺子。
下次再看到一个「百分之多少」的占比,先问三件事:量的单位是什么,是 Token 还是算力;量的范围是什么,是一家公司还是全行业、推理侧还是训练侧;谁来统计的,有没有说方法。

