「国内超一半算力在造爽剧」刷屏,豆包下场打假:AI 烧掉的算力到底喂了谁
- 2026-11-19 10:17:22
过去一周,很多人的时间线被同一句话刷屏了:国内超过一半的 AI 算力,正在用来造爽剧。
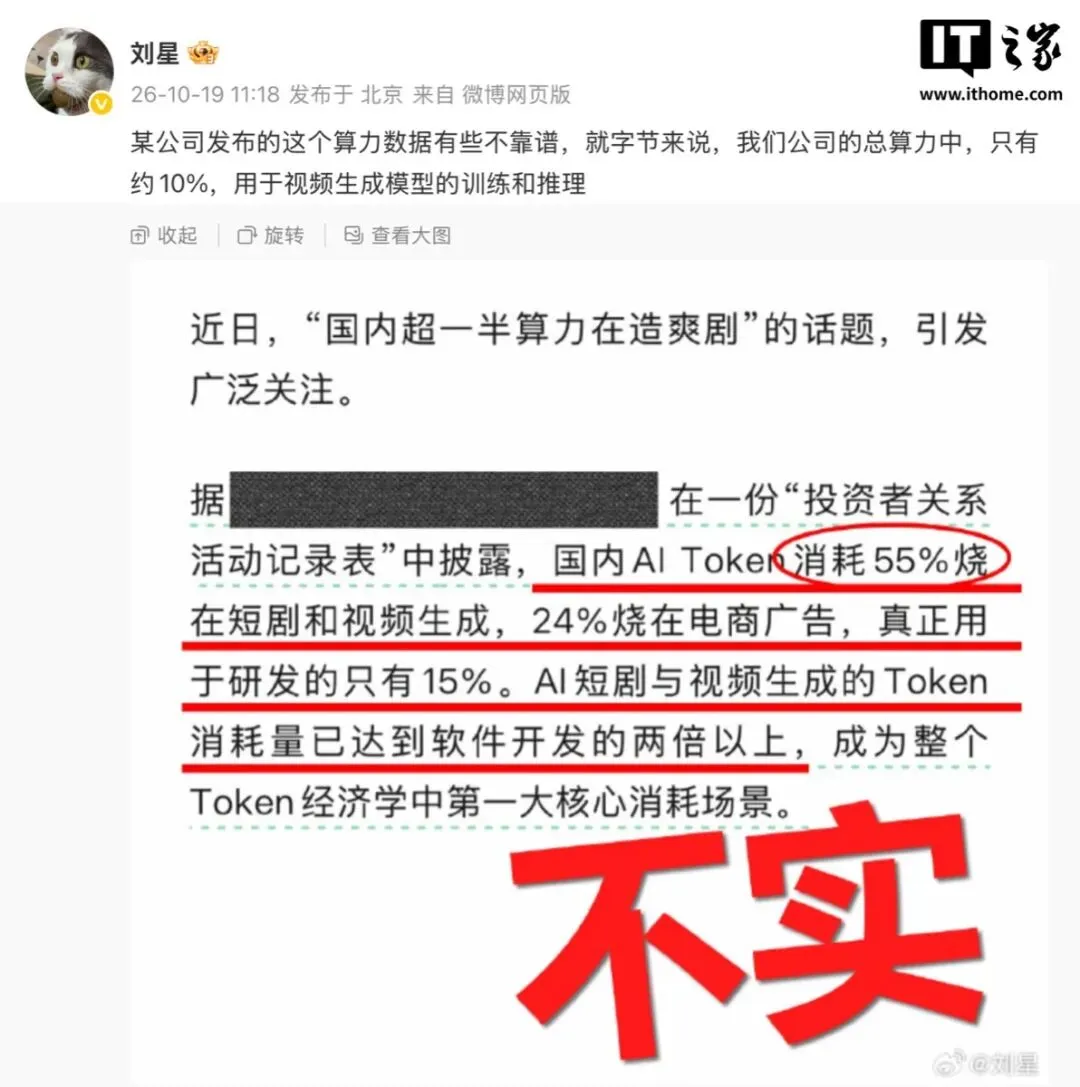
国家烧钱建智算中心,大厂抢卡抢到断货,结果一半算力都喂给了"龙王赘婿"式的 AI 短剧?这个数字太完美,完美到每个人都愿意相信它——直到 10 月 19 日,豆包公关负责人刘星公开下场:这个数据,不靠谱。
这个惊悚数字,到底从哪来的
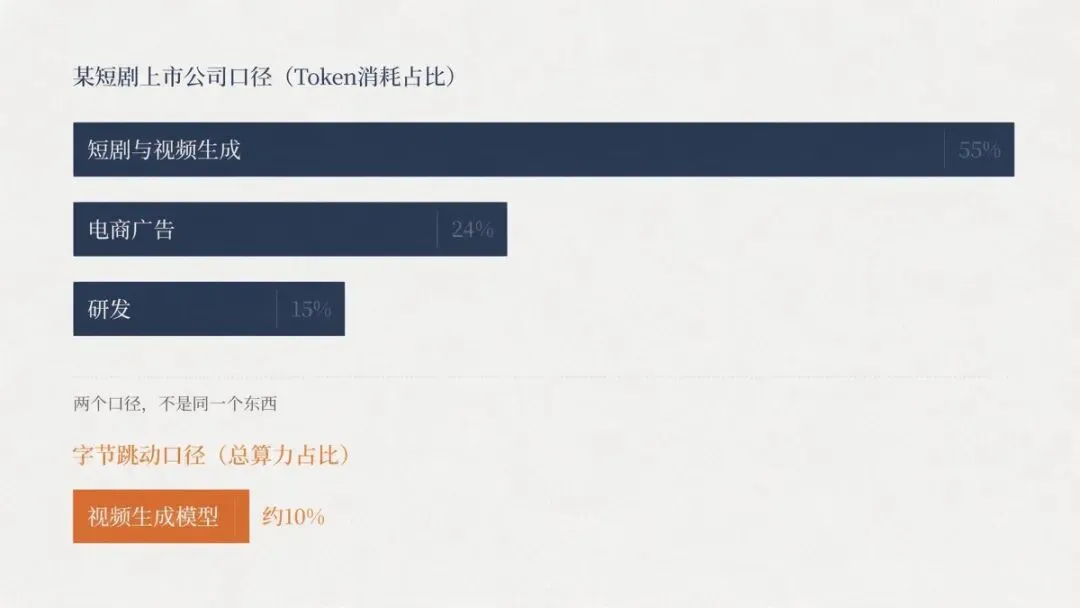
先说源头。这个说法出自 A 股上市公司中文在线的一份《投资者关系活动记录表》,里面的原始表述是:国内 AI Token 消耗中,55% 烧在短剧和视频生成,24% 烧在电商广告,真正用于研发的只有 15%。
注意两个细节。
第一,这是 Token 消耗占比,不是物理算力普查。Token 是模型推理的计量单位,它反映的是"谁调用 API 调得多",而不是"全国显卡在跑什么任务"。一个在自家业务里重度依赖视频生成的公司,看到的 Token 结构天然会向短剧倾斜。
第二,中文在线本身就是重仓短剧赛道的玩家。一家 All in AI 短剧的公司,在投资者关系材料里告诉你"短剧是 Token 经济的第一大消耗场景"——这话可能是事实,也可能是叙事,更可能两者都是。
字节的口径:只有约 10%
刘星给出的字节口径是:公司总算力中,只有约 10% 用于视频生成模型的训练和推理。
字节是什么体量?国内 AI 视频生成最激进的玩家之一,即梦、豆包视频、剪映全系产品都在烧这块的算力。如果连字节都只有约 10% 的算力分给视频生成,"全国 55% 算力造爽剧"在物理层面几乎不可能成立。
两个数字差的不是一点,是五倍。因为它们量的根本不是同一个东西:一个是某家公司视角下的 Token 调用结构,一个是物理算力的分配。把前者包装成后者,惊悚感就是这么被制造出来的。
为什么所有人都愿意信
假数据刷屏的速度,往往和它的"情绪精准度"成正比。
这个 55% 精准踩中了两根神经。一根是算力焦虑:中美 AI 竞争的大背景下,"算力"早就被叙事成了战略资源,每一张卡都应该用在刀刃上。另一根是价值判断:短剧在很多人的认知里就是"精神鸦片",于是这个等式瞬间成立——国家级的战略资源,正在批量生产精神鸦片。
焦虑加愤怒,再配上一个具体到小数点级别的数字,转发根本不需要理由。至于这个数字出自一份投资者关系记录、统计口径是什么、有没有交叉验证,没人在乎。数据被污染的链条很清晰:单一企业的投资者口径 → 自媒体提炼成"一半算力"→ 情绪放大器推到全民恐慌。
但爽剧烧算力这件事,是真的
打假归打假,有些事不能被一起洗掉。
AI 短剧确实是 Token 消耗的黑洞。据行业数据,一部 12 集的 AI 短剧,要烧掉近 20 万元的算力成本;仅抖音一个平台,今年上半年就新上线了 22 万部 AI 短剧;今年前 8 个月,国内上线的微短剧总数达到 43 万部,是去年全年的 13 倍。
成本为什么降不下来?因为制作方式是"抽卡"——为了符合导演对镜头和叙事的要求,团队要反复生成、反复筛选,每一次"再来一条"都是实打实的 Token 燃烧。对画质要求更高的 AI 仿真人剧,Token 消耗量是 720p 漫画风短剧的两到三倍。
广电总局发展研究中心今年 4 月发布的报告显示,2025 年中国微短剧市场规模突破 140 亿美元,占全球市场的近八成。这是一个用算力堆出来的千亿级产业。
所以字节那句"只有约 10%"也不必读得太轻松——以字节的算力总量,10% 依然是一个惊人的绝对值。
真正该问的问题
"一半算力造爽剧"是假的,但它引爆的焦虑是真的。而这个焦虑指向一个值得认真讨论的问题:AI 烧掉的算力,到底喂了谁?
我的看法是,别把"研发"和"应用"对立起来。视频生成是今天大模型竞争最激烈的战场之一,短剧恰恰是它最大的练兵场和现金流来源——没有这 55% 的 Token 消耗,视频模型迭代的钱从哪来?当年游戏显卡养出了 GPU 产业,才有了后来的 AI 算力革命。技术史上,"不体面"的应用养活"体面"的底层技术,不是第一次。
真正需要警惕的,不是算力喂给了爽剧,而是我们的公共讨论越来越容易被一个未经核实的数字劫持。下次再看到一个精确到百分比的惊悚结论,先问一句:这是谁说的,他量的是什么,他为什么这么说。
毕竟在这个时代,比算力更稀缺的,是辨别数据真伪的耐心。

