“中国一半AI算力在造爽剧”是真的吗——数据本身不骗人,骗人的是选择性呈现
- 2026-11-08 00:09:17
“中国一半AI算力在造爽剧”是真的吗——数据本身不骗人,骗人的是选择性呈现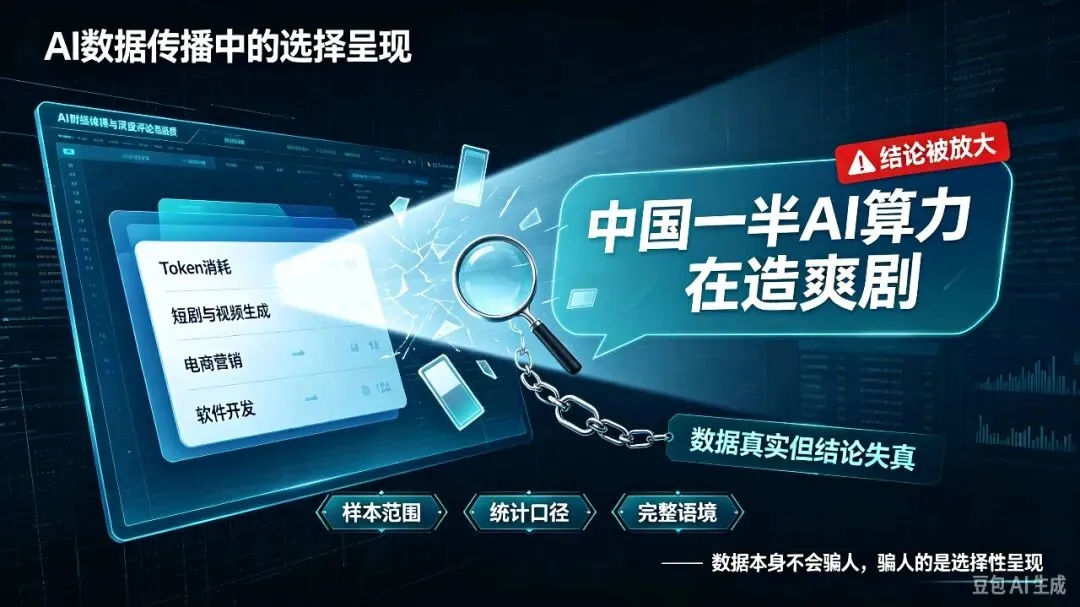
昨天,一条“中国一半AI算力在造爽剧”的短视频,让我看了之后浑身一紧,可是随后我会问自己,这个内容是真实的吗? 这条视频发布仅一天,就有5000多次转发,1000多个推荐和点赞。 数据有出处,但结论被严重放大。一个企业样本的API调用统计,被说成“中国AI算力的一半”;一个特定场景的Token消耗,被包装成中美AI战略的分野。传播很广,但这是不对的。 这就是典型的选择性呈现:用的都是真数据,得出的却是错误结论。 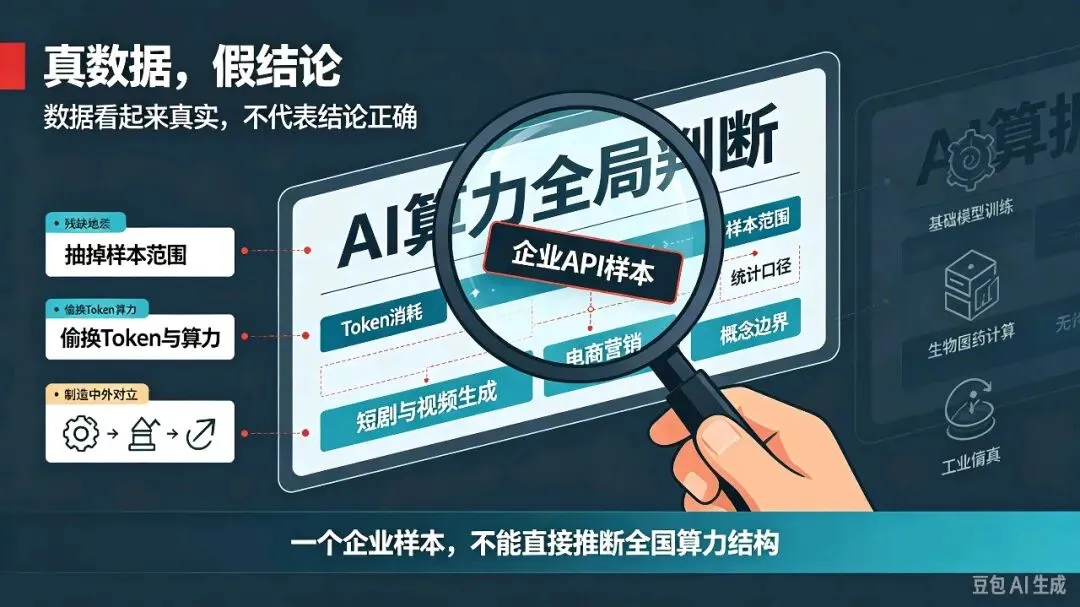
选择性呈现通常三步: 抽掉样本范围。 中文在线统计的是面向内容创作者的公开API调用量。大量企业私有集群里的基础模型训练、生物医药计算、工业仿真,根本不在这个样本里。拿一个企业样本推断全国算力结构,不严谨。 偷换概念。 Token消耗不等于算力,更不等于技术投入。视频生成Token多,是因为视频算力密度远高于文本,不是中国把一半AI资源都拿去造爽剧。 制造对立。 “中国在造爽剧,美国在造未来”听起来刺激,却忽略了产业阶段差异。中国有全球最大的内容消费和电商市场,AI视频落地后,最先跑出规模的自然离钱最近。把阶段性差异说成文明优劣,是用情绪替代分析。 彻底造假容易被识破,选择性呈现披着事实外衣,让偏见看起来有理有据。 它扭曲认知:公众记住“55%”,却看不到基础研发、工业仿真、生物医药的真实投入。 它制造焦虑:不是“天塌了”,而是慢性怀疑——我们是不是又走错了? 它干扰判断:如果决策被这种简化叙事裹挟,可能误判应用场景价值和基础研发投入。 它侵蚀信任:当人们发现数据也能骗人,会对一切数据产生怀疑,包括真实预警。 钛媒体有专业能力,更应清楚样本范围和统计口径意味着什么。 客观失真,是认知局限或信息不完整导致的偏差,可以理解。主观造假,是为了流量和情绪,明知数据有局限却故意不标注、不解释、不还原语境。前者是能力问题,后者是态度问题。 不管是官方媒体还是网络自媒体,只要面向公众传播,就应当承担公共责任。底线很简单:传播可以因认知局限而客观失真,但绝不能因利益驱动而主观造假。 用“中国一半AI算力在造爽剧”做标题,不只是失实,更是透支公众信任。 这类内容游走在事实和谣言之间的灰色地带。规定禁止“标题与内容严重不符”,但数据确实有出处,只是样本被抽掉、概念被偷换。认定难,取证难,跨平台协同更难。 它不以谣言面目出现,而以“分析”“解读”出现,传播的是一种经过筛选的“真实”。这是现有治理框架最难覆盖的区域。 平台:对宏观数据、行业比例、中外对比内容,要求标注原始来源、样本范围、统计口径;对断章取义标题降权、提示。 行业:重建数据伦理。完整性优先于冲击力,语境优先于结论,公平对比优先于煽动对立。 公众:建立“数据怀疑链”。看到惊人结论,先问:谁说的?样本多大?口径是什么?原始报告在哪?对比公平吗?越是让你愤怒或焦虑的数据,越值得多看一眼来源和语境。 当我们在网上看到惊人话题、数据或是结论时,不妨先问自己几个问题: 原始报告在哪? 谁发布的,有没有完整出处? 样本多大? 能代表全国、全行业,还是只是一个企业、一个平台? 口径是什么? 有没有混着用? 对比公平吗? 是不是拿中国某场景对比美国另一场景? 标题和数据匹配吗? 是数据支撑结论,还是情绪支撑标题? 发布者利益相关吗? 有没有商业动机、流量动机? 有没有相反数据? 其他来源怎么说? 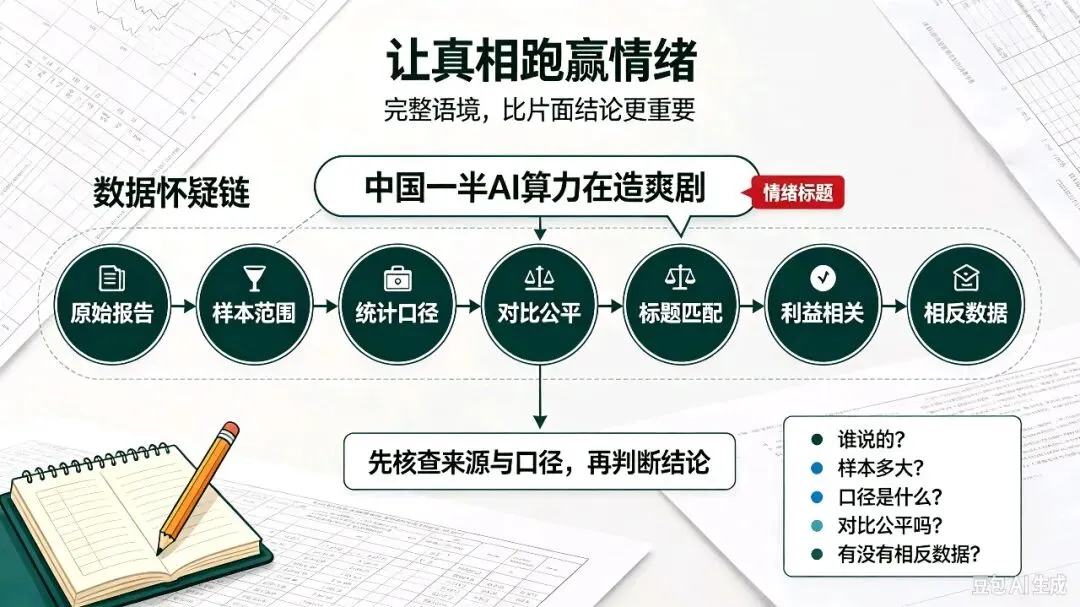
数据本身不会骗人,骗人的是选择性呈现。治理不是让网络媒体闭嘴,而是让公共讨论建立在可核查的事实和完整语境之上。让真相跑赢情绪,让完整语境跑赢片面数据。
视频出自《钛媒体》对中文在线投资者交流记录的报道:其统计的AI Token消耗中,55%流向短剧和视频生成,24%流向电商营销,软件开发仅占15%。
一、真数据,假结论
二、危害:片面真实比彻底造假更危险
三、媒体责任:可以客观失真,不能主观造假
四、治理难:真实数据+片面解读,难认定
五、网络媒体该怎么做
附:识别清单
最后的话
“中国一半AI算力在造爽剧”真正值得警惕的,不是数据本身,而是传播模式:用真实数据制造虚假印象,用选择性呈现替代完整分析,用情绪冲突替代理性讨论。
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

