国内一半算力在造爽剧?我们可能看错了中国AI
- 2026-11-17 21:25:37
最近,一则新闻相当炸裂:国内55%的AI Token消耗在短剧和视频生成上,24%用于电商营销,而软件开发仅占15%。
这组数字来自上市公司中文在线披露的投资者关系活动记录,随后被媒体演绎成一个更具冲击力的标题——“国内超一半算力在造爽剧”。
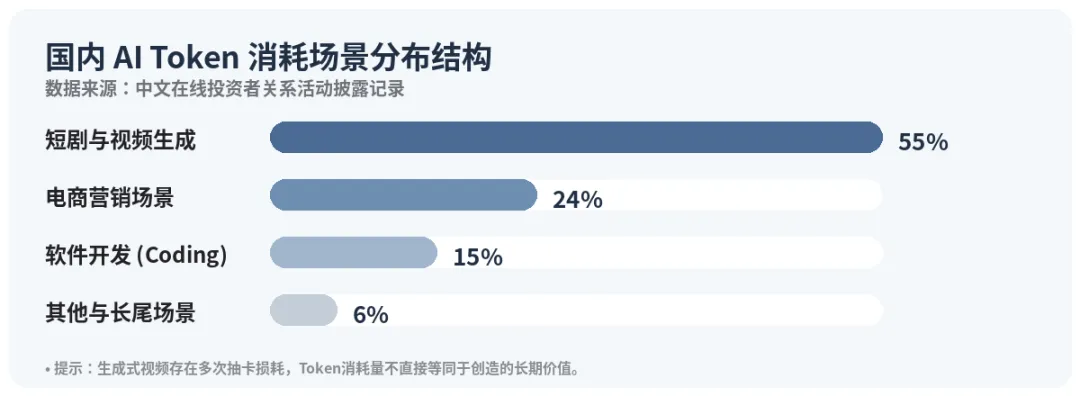
国内 AI Token 消耗场景分布结构(中文在线公开披露)
消息一出,不少人的第一反应是:美国人在用AI搞科研、写代码,中国人却在用AI生产霸总短剧?
乍看之下,这似乎是一幅颇具讽刺意味的AI产业图景。但仔细研究之后,我认为事情可能远没有这么简单。
我们看到的,究竟是中国人使用AI的真实需求,还是中国AI产业能够承接的需求?
这可能是理解整个现象的关键。
一个被忽略的变量:中国AI模型的竞争力并不均衡
真正让我觉得有意思的是,国内外AI模型在不同领域的竞争格局。
在视频生成领域,中国模型已经站在世界第一梯队。字节跳动的Seedance、阿里巴巴的Wan等模型,在国际独立评测中表现突出,部分能力甚至位居前列。
对于中国的视频制作团队而言,既然本土就有全球顶尖的视频生成模型,而且拥有成熟的商业化服务体系,自然没有太大必要舍近求远。
但换到另一个场景,情况就不一样了。
在复杂Coding Agent、长时间自主执行等高难度任务上,Claude、GPT、Gemini等海外闭源模型依然具有很强的竞争优势。
尽管DeepSeek、Kimi、GLM、Qwen等国产模型进步飞快,部分评测已经接近甚至进入第一梯队,但对于追求极致任务完成能力的开发者而言,海外模型依然是重要选择。
这就产生了一个非常值得思考的现象:
中国的视频生成需求,能够大量转化为国产模型的调用;而中国的复杂编程与科研需求,却可能有相当一部分流向海外模型。
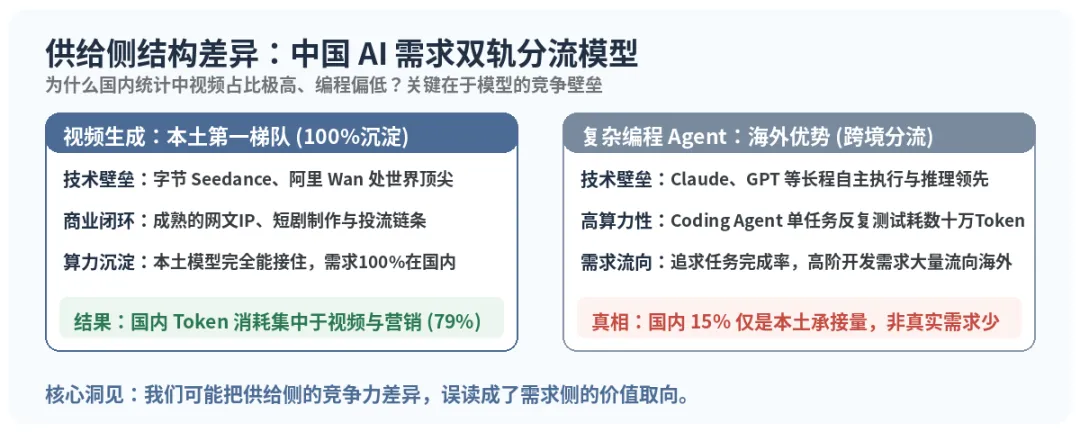
供给侧结构性差异:中国 AI 算力与需求双轨分流模型
而且,Coding Agent并不是什么低算力消耗场景。
一个复杂任务可能需要AI反复阅读代码库、规划方案、调用工具、运行测试,再根据结果继续推理,产生数十万甚至更多Token。
如果这些任务通过海外模型完成,那么中国开发者实际创造的AI需求,并不一定完整地反映在国内模型平台的调用统计里。
当然,目前还没有足够的数据证明这种跨境分流究竟占多大比例。但它至少提供了一种合理的解释:国产模型在不同领域的竞争力差异,可能直接塑造了我们所观察到的国内Token消费结构。
换句话说,我们可能把供给侧的结构差异,误读成了需求侧的价值取向。
为什么即使如此,短剧依然会消耗大量Token?
统计口径和模型竞争力是一部分原因,但不能因此忽略短剧自身的商业优势。
中国拥有庞大的网络文学IP、成熟的短视频分发平台、内容制作产业链,以及广告与付费变现机制。
AI视频生成恰好能够无缝嵌入这套体系。
过去需要演员、摄影棚、服化道才能完成的部分制作,如今可以通过AI生成。作品上线后,很快就能根据播放、点击、付费转化等数据判断商业价值。
反观AI进入传统企业,需要面对数据治理、系统集成、流程改造、组织协同等一系列复杂问题。即使最终创造的价值更大,验证周期也往往更长。
资本和算力天然倾向于率先流向那些商业回报更容易验证的地方,而不一定是长期价值最高的地方。
还有一个值得注意的细节:AI短剧制作过程中,导演为了获得满意的镜头,往往需要不断重新生成、筛选素材,也就是所谓的“抽卡”。
这意味着,大量Token消耗既体现了生产规模,也可能反映当前视频生成技术仍然存在的不确定性。
消耗更多Token,未必意味着创造了更多价值。
比Token消耗更值得关注的,是中国AI能接住多少需求
如果把这些因素放在一起,整个现象就有了一种不同的解释。
中国AI视频生成之所以繁荣,可能是因为它同时满足了三个条件:本土模型足够强、现成商业场景足够大、商业回报相对容易验证。
而软件开发、科研和企业自动化,即便拥有巨大的潜在需求,也可能因为模型竞争力、组织落地难度,以及计算服务流向海外等因素,没有表现为同等规模的国内Token消费。
这并不意味着中国AI产业只会生产娱乐内容。恰恰相反,国产视频模型在全球竞争中表现突出,本身就是一种值得肯定的技术和产业成就。
但短剧的成功,也无法代替其他领域的技术突破。
未来真正值得观察的,不是中国能否消耗更多Token,而是国产模型能否在Coding Agent、复杂推理、科学研究和企业自动化等领域持续提升竞争力,将更多高价值需求转化为实际生产力。
因为对于一个国家的AI产业而言,最值得衡量的,从来不只是消耗了多少计算资源,更是这些计算资源最终创造了多少价值。
回到开头那则新闻。
所谓“国内超一半算力在造爽剧”,我们看到的可能不是中国人把AI用在了什么地方,而是中国本土AI产业率先成功承接了哪些需求。
这两者之间的区别,或许才是这则新闻真正值得思考的地方。

