「中国一半算力在造爽剧」?吵了三天,大多数人连这两个词都没分清
- 2026-11-20 14:16:42
一条热搜把整个 AI 圈吵翻了:「中国一半算力在造爽剧」。
有人痛心疾首:美国 58% 的词元在写代码搞自动化,我们 55% 在拍"霸总爱上我",这不就是"西方用火药造枪炮,我们用火药造烟花"?
也有人直接开怼:数据不靠谱,别带节奏。
吵了三天,双方各执一词。但如果把情绪摘掉,你会发现这场争论的核心,其实是两个被大多数人混用的词:Token 和算力。
今天把这笔账拆开算给你看。
一、这笔账,是怎么吵起来的
事情源头是一份投资者关系记录。上市公司中文在线披露:国内 AI Token 消耗中,55% 用于短剧和视频生成,24% 用于电商广告,只有 15% 用于研发。
10 月 19 日,豆包公关负责人刘星在微博回应:"某公司发布的这个算力数据有些不靠谱,就字节来说,我们公司的总算力中,只有约 10% 用于视频生成模型的训练和推理。"
一边说 55%,一边说 10%,差了五倍多。问题出在哪?
出在两个数字量的根本不是同一样东西。
二、先补课:Token 和算力,根本不是一回事
打个比方——
Token,像你家的"水表读数":你在 App 里每调一次大模型、每生成一段文字或画面,都按 Token 记账。它反映的是"调用量"。
算力,像"自来水厂和水管":真正干活的 GPU 机器,反映的是物理设备的计算能力。
水表转得快,不代表你家偷用了全城水厂的产能——因为不同用途,"耗水密度"天差地别。
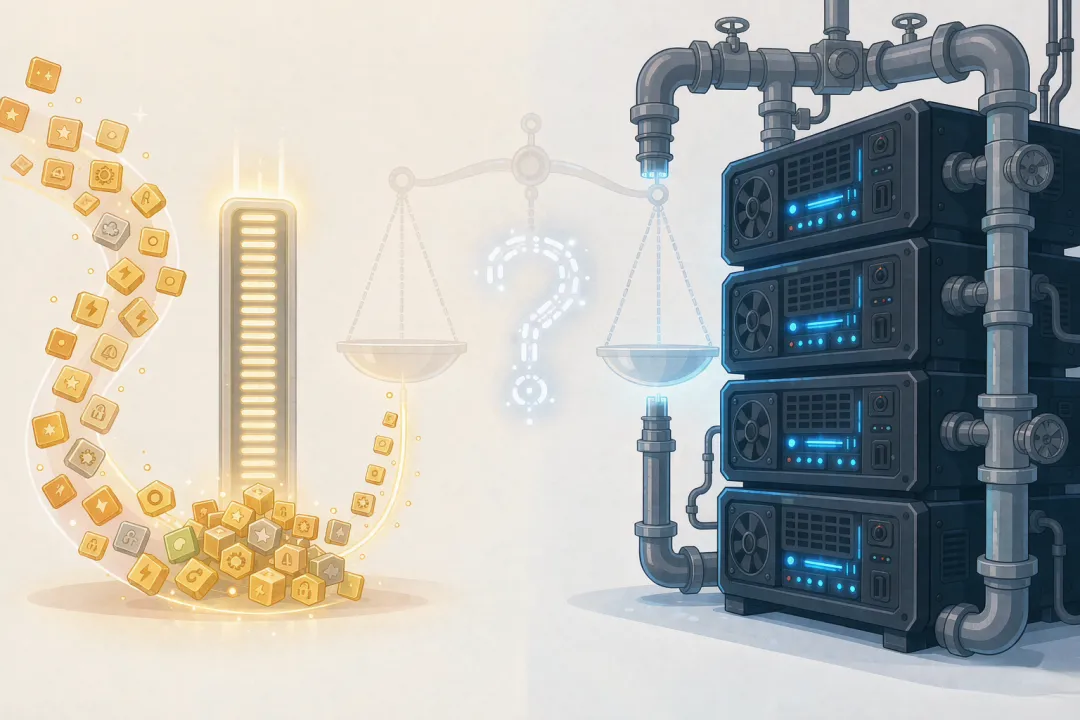
短剧就是典型的"耗 Token 大户":720p 分辨率下,生成一条 5 秒镜头约需 10 万 Token,相当于处理一整部十万字的小说;一部 90 分钟的 AI 短剧,成片 Token 消耗可达 1.1 亿。再加上导演不满意就"抽卡"重新生成,一部剧烧掉数亿 Token 轻轻松松。
而写代码恰好相反:科研场景做模型预训练、微调,GPU 算力投入很重,Token 却"烧"得很少。
所以,"短剧 Token 占 55%"和"全国一半算力在造爽剧"之间,隔着一条概念鸿沟。
再往细里拆,还有第二组被混用的概念:训练算力和推理算力。DataEye 研究院负责人刘尊解释:AI 短剧绝大多数 Token 消耗集中在推理环节,大量使用通用模型和中低端显卡;而科研和基础大模型训练用的是高端算力。两者采购主体、硬件型号、成本结构都不一样,属于两条相对独立的供给线。短剧烧 Token,和科研抢卡,不是直接竞争关系。
三、两边的账,各有一本
反驳派的账:
1. 豆包自报:总算力仅约 10% 投入视频生成模型的训练和推理;
2. 口径不可比:国内 55% 统计的是推理侧 Token 消耗(含视频配套文本),网传"美国 58% 写代码"多来自代码大模型的统计——统计边界、模型类型、样本范围完全不同,中新网评论直言"简单比较就会失真";
3. 很多科研机构用自建算力,根本不在"公有 API Token"的统计范围内。
担忧派的账:
1. 即使口径有瑕疵,现象是真实的:今年前 8 个月国内上线微短剧 43 万部,是去年全年的 13 倍;仅抖音上半年就新增 22 万部 AI 短剧;
2. 中国新闻网的评论也承认:部分基础科研团队获取高端算力成本偏高、等待周期较长,算力资源的结构性矛盾客观存在;
3. 大量资本涌向"赚快钱"的应用层,"重应用落地、轻底层攻坚"的倾向,值得产业界警惕。
四、被吵火的那场戏,自己也在亏钱
有个黑色幽默的细节:这场争议的"主角" AI 短剧,自己活得也没那么爽。
DataEye 监测显示:上半年抖音新增的 22.19 万部 AI 剧中,播放量破亿的仅 1055 部,占比 0.48%;行业盈亏平衡线是 5000 万播放,达标者仅 1.3%。算下来,每 77 部 AI 短剧里,只有 1 部能盈利。每万次播放的收益,从去年的 30-100 元,降到了今年的 5-10 元。
算力在贬值,创作门槛在下降,但"被看见"的门槛一点没降。
五、最后说两句
回到最初的问题:中国一半算力在造爽剧吗?
大概率不是。Token 账单不等于 GPU 负载,娱乐推理不挤占科研训练,中美两组数据也不在同一个口径上。
但这波争议也不算白吵——它用三天时间,给全网免费上了一堂 AI 概念课:看懂一组数据之前,先问一句"统计的是什么"。
技术路线之争可以继续,但下一次再有人拿一个百分比点燃你的情绪,不妨先冷静三秒:他说的是水表读数,还是水厂产能?
你觉得 AI 算力应该优先"造爽剧"还是"搞科研"?评论区聊聊。
觉得这篇把账算清楚了,点个"在看",转给那个正在焦虑的朋友。
#AI算力 #Token #AI短剧 #大模型 #人工智能 #微短剧 #科技热点
参考信源:中文在线投资者关系活动记录、豆包公关负责人微博回应(2026年10月19日)、《中国新闻周刊》、中国新闻网评论《别让片面比较带偏AI讨论》(2026年10月22日)、DataEye研究院、中国信通院《词元(Token)经济发展研究报告(2026年)》。

