我把一段古装短剧,拆成了 18 个镜头
- 2026-11-20 16:03:02
剧本写完的第二个夜晚,我在桌前坐了半小时没动。
面前摊着 40 页短剧剧本,写的是唐代长安的一场雨夜。人物、动作、台词都写完了,下一行该是分镜表——可我盯着空白的第一格,脑子里全是问号:
这一镜用中景还是近景?镜头是推还是摇?这一句台词念完要几秒?光从哪来?夜里下着雨,主光给宫灯还是给月色?更要命的是:沈昭从袖子里摸出来的那枚玉璧,是组玉还是汉玉?她穿的襦裙是间色还是素色?安仁坊的坊门关上之前,这一镜要留多长?
通用分镜模板能拆场次、能算时长,但它们不懂唐代。不懂幞头有软脚硬脚之别,不懂博山炉的烟是从山间升起的,不懂“三品服紫、五品服绯、六品七品服绿”这套服色品级制度,也不知道上元之夜坊门大开的点灯规矩。
那一刻我意识到:我要的不是又一个分镜模板,是一个懂这个朝代的分镜工具。
于是有了「镜枢」。
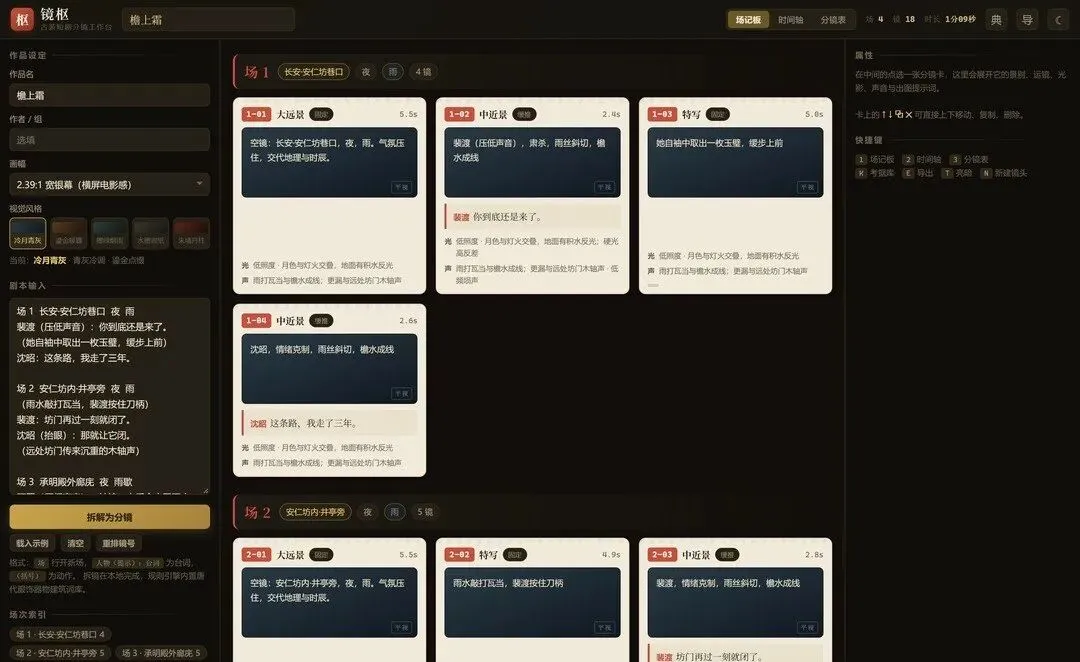
— 镜枢 · 场记板总览
一、它是怎么把戏拆成镜头的
整个拆解引擎跑在浏览器本地,没有调任何 API,断网也能用。逻辑不复杂,但每一条规则都是从“分镜表上真实会怎么写”倒推出来的。
台词 → 时长。 中文口播大约每秒 4.2 字,按字数换算时长并加上起落的呼吸。超过 16 字的台词会自动补一个反应镜——因为没有人能在镜头里一口气说那么长还好看。
动作动词 → 景别与运镜。 “取/握/按”落在特写,“走/步”给中景跟拍,“转身”用横移,“抬头”缓推、“低头”缓拉。动词表覆盖了古装戏里最高频的一批动作。
语气提示 → 情绪 → 光影。 这是我觉得最有用的一条。剧本里写 裴渡(压低声音):,括号里的提示不是装饰,它会参与判断:压低声音 → 肃杀 → 硬光高反差 + 面部半明半暗 + 眼神有锋。一个括号的差别,出来的是完全两种光。
时辰 + 天气 → 光位与关键光。 夜 + 雨 = 低照度、月色与灯火交叠、地面有积水反光、雨幕散射把环境光抬高;暮 + 晴 = 金色侧逆光、落照低角度穿透;雪天则要补一句“雪地高反照率,人物下部补光”。
长台词自动补反应镜。 超过阈值就在台词镜后加一个特写:落在对手的反应上,或落在手部与物件细节。
实测一下。原始剧本是这样:
拆出来是四个镜:
第一镜是自动生成的建立镜头——分镜表的标准做法,用一个空镜把地理和时辰交代清楚,再切人物。第二镜的“肃杀”是从“压低声音”推出来的。第三镜“取”字给了特写。
二、60 条唐代考据,是怎么挂到镜头上的
这是镜枢和通用工具真正拉开差距的地方。
它内置了 60+ 条词条,分六类:服饰(幞头、襦裙、披帛、蹀躞带、蔽膝、鹤氅、面靥、簪花)、器物(博山炉、海兽葡萄镜、螺钿紫檀木、金银平脱、玉璧、宫灯、团扇、漆盒、药箱)、建筑(鸱尾、庑殿顶、丹楹粉壁、十字街坊墙、含元殿、曲江池、牌坊、更漏台)、天象时令(上元、寒食、清明、月相、二十四节气、更漏五更)、器乐乐舞(十部乐、霓裳羽衣曲、羯鼓、琵琶筚篥、梨园坐部立部)、饮食(胡饼、驼蹄羹、春酒屠苏、匕箸)。
每条词条都写了它“是什么”和“为什么重要”,不是干巴巴的名词表。比如博山炉那条:*汉魏以来流行的熏炉,形似重叠山峦,焚香时烟从山间升起*——这句直接就能进画面描述。
剧本里一出现关键词,自动挂到对应镜头上。上例中“玉璧”命中器物类,“披帛”命中服饰类,“廊庑”“承明殿”命中建筑类。
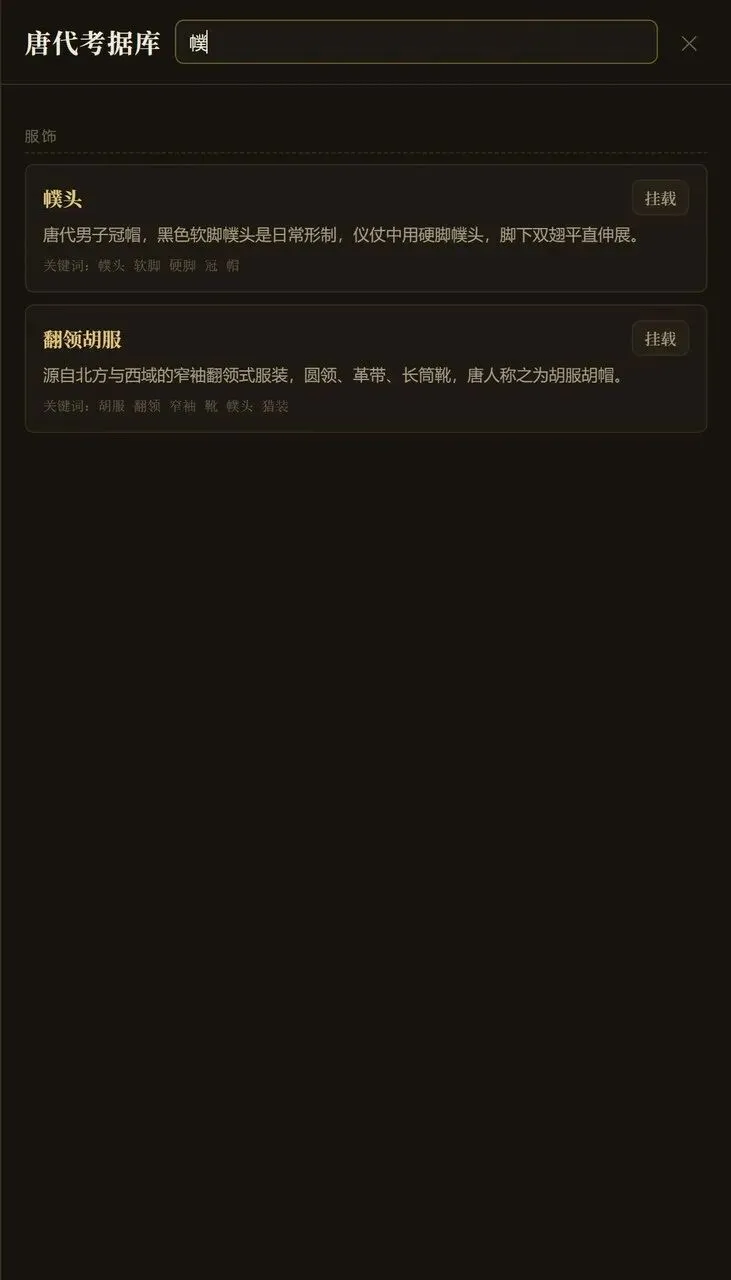
— 唐代考据库
考据库也可以全文检索,手动往任意镜头上挂——这是给那些词库还没覆盖到、但你心里有数的细节留的口子。
三、分镜卡到出图,只差一次复制
拆完之后,每一镜会自动生成一条完整的出图提示词:
背景、人物、动作、台词、道具、光影、环境、音色、镜头参数,一行不缺。右上角五种视觉风格预设(冷月青灰 / 鎏金暖暮 / 墨绿烟雨 / 水墨宣纸 / 朱墙丹柱)会同时改写色彩与质感那一行——换风格时整套提示词跟着换,不用逐条手改。
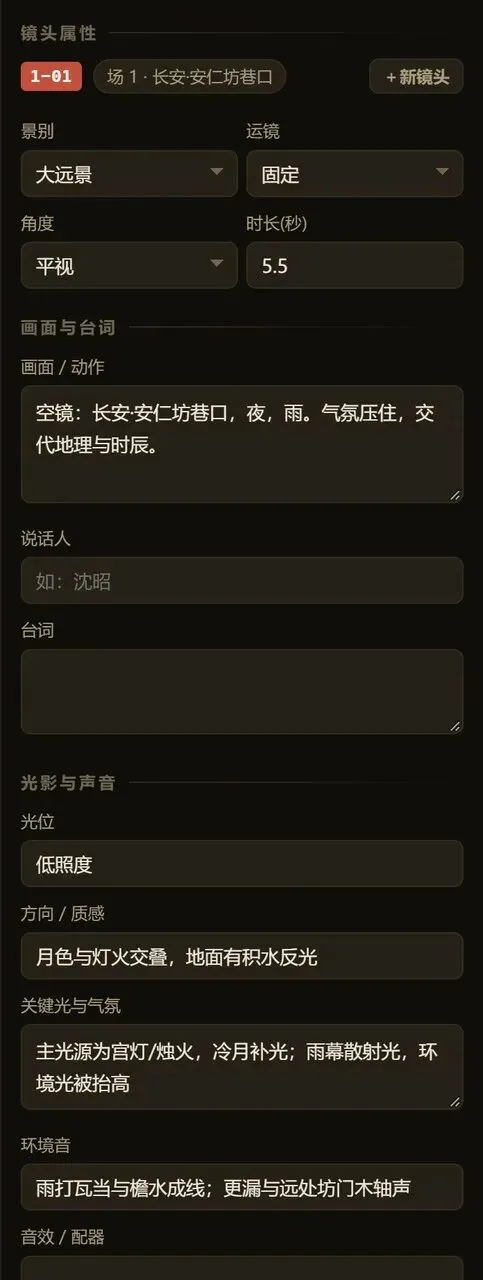
— 镜头属性与出图提示词
四、三个视图,对应三种人
场记板——一张卡一个镜头,视觉化审戏。鼠标悬停就能上下移动、复制、删除。这是改戏用的。
时间轴——按场次排布的时码条。它会告诉你这一场 5 个镜共 17.4 秒、平均镜长 3.5 秒,第 3 场有没有拖沓。节奏问题看表格看不出来,看条形图一眼就明白。
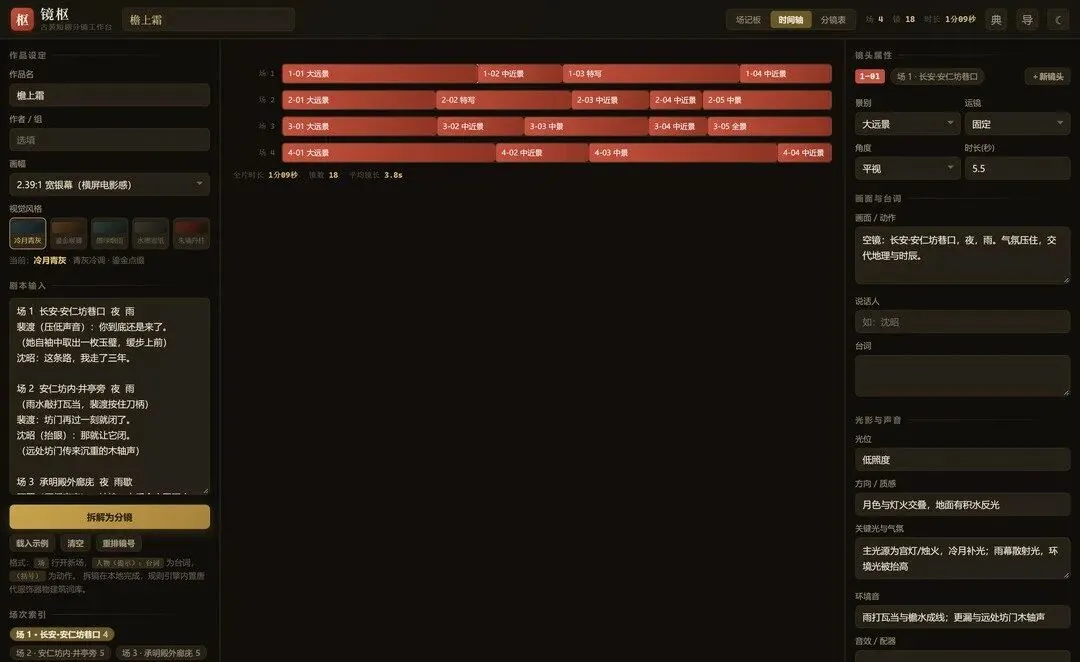
— 时间轴
分镜表——标准十列分镜表:镜号、景别、运镜、时长、画面、台词、光影、声音、考据,按场次分节。这一张可以直接打印成 A4 横版 PDF 交给摄影组。
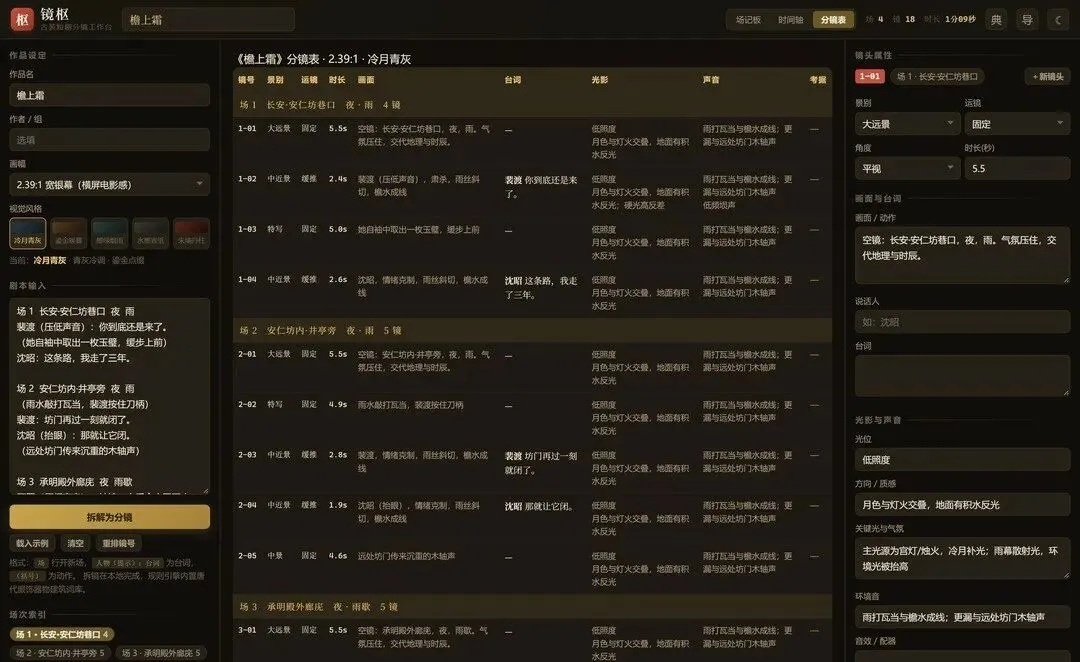
— 分镜表
还能一键导出 1080 宽的竖版分镜卡长图(下面这张),直接发朋友圈或小红书,不用再开一次设计软件排版。
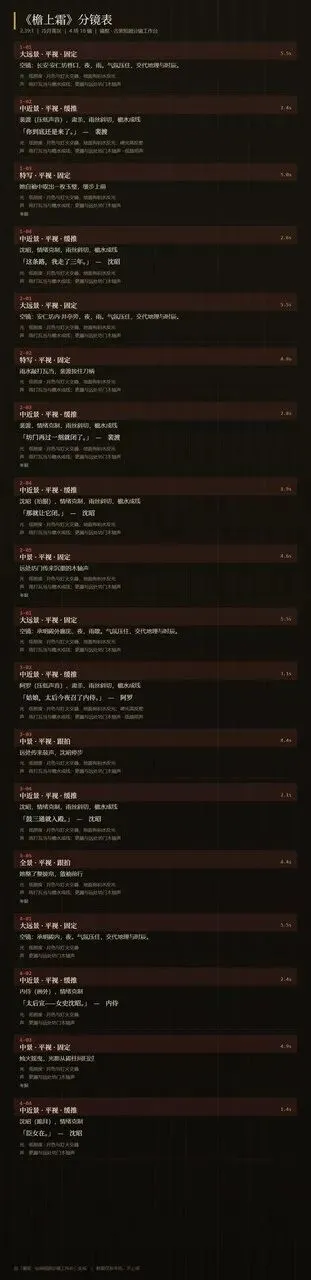
— 分镜卡长图
五、为什么我坚持做成一个文件
这几个决定看起来像技术洁癖,其实是产品判断:
单文件、零依赖、零后端。 点开链接就要能用——不需要注册、不需要等依赖安装、不需要配 API Key。断网也能跑完整条链路。装依赖失败导致别人打不开,是我见过最可惜的丢分方式。
数据只存本地。 剧本是未发表的东西,存浏览器 localStorage,不上传、不联网、无账号。清浏览器数据即清空,也可以导出 JSON 留档。
规则引擎不依赖大模型。 拆镜是确定性计算,不需要联网请求,不烧 token,也不会因为模型抽风把一整场戏拆崩。真正干活的部分必须离线可靠。
亮暗双主题 + 移动端底部标签。 审戏常常在晚上、在路上、在手机上看。
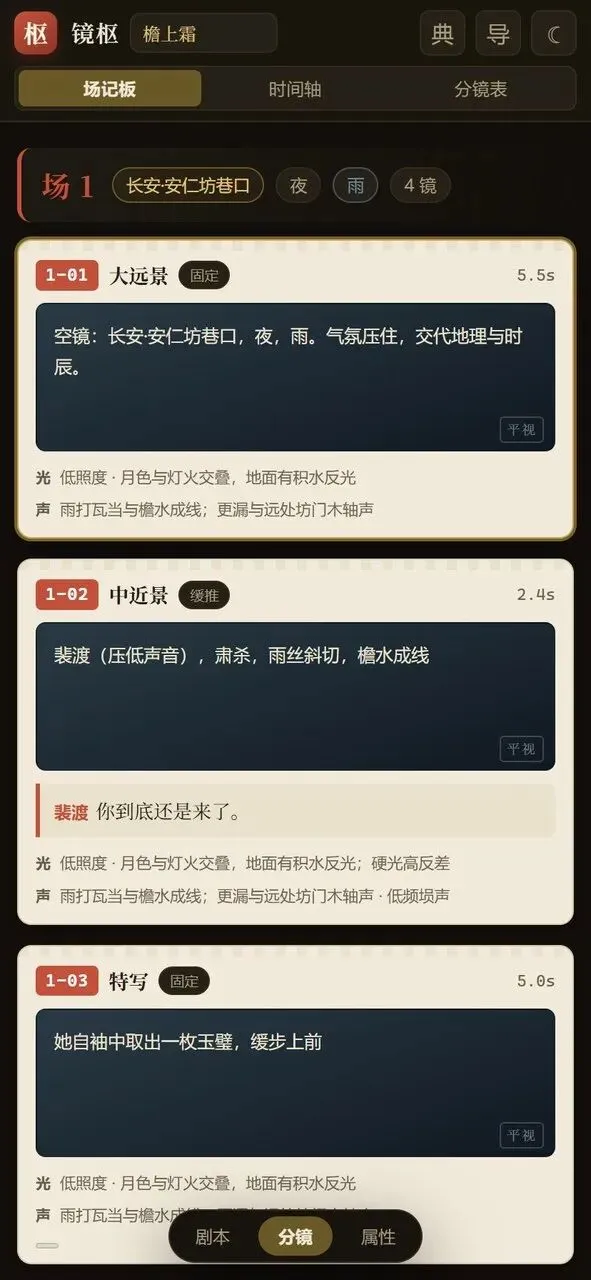
— 移动端
六、现在轮到你了
体验地址(无需注册,直接打开):
https://buddy-trip-planner-22669.app.workbuddy.host/
上手三步:
1. 左侧「剧本输入」粘一段戏,或点「载入示例」看内置的原创短剧《檐上霜》第一集(4 场 18 镜);2. 点「拆解为分镜」;3. 中间点卡片改参数,右栏复制提示词,E 键导出长图与分镜表。
快捷键:1 场记板 2 时间轴 3 分镜表 K 考据库 E 导出 T 亮暗 N 新建镜头
如果你也写古装短剧、也做分镜,最想听你吐槽的是:“我明明描述对了,它却没匹配到”——考据词库总有覆盖不到的地方,你把该有的词告诉我,我一条条加进去。
这个小工具从需求到上线,全程在 WorkBuddy 里完成:活动细则拆解、选型推演、界面与交互设计,拆镜规则引擎编写、唐代考据词库逐条考据撰写、端到端交互测试与零 JS 报错验证,最后发布为在线链接、写完这篇文章。
程序员节最好的过节方式,不是看别人造轮子,是自己上手造一个。哪怕它只解决了你一个人的问题。
体验地址:https://buddy-trip-planner-22669.app.workbuddy.host/
欢迎试用,也欢迎把不顺手的地方直接怼我——每一句反馈都是下一版的原料。
#WorkBuddy #1024程序员节

